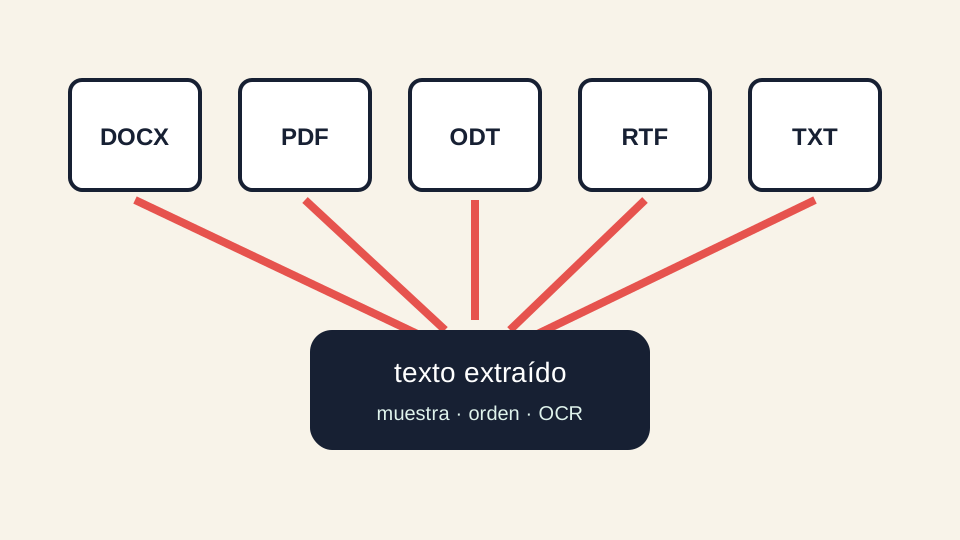
Respuesta breve: DOCX, ODT, RTF, TXT y PDF no contienen el texto de la misma manera. TXT es texto plano; DOCX y ODT son paquetes estructurados; RTF mezcla contenido y códigos; un PDF guarda una representación de página y puede ser solo una imagen. Por eso “abrir y contar” requiere métodos distintos.
Qué esperar de cada formato
| Formato | Qué conserva | Riesgo principal |
|---|---|---|
| TXT/MD | Texto y saltos simples | Codificación |
| DOCX | Documento, estilos, notas y objetos | Texto en cuadros o notas |
| ODT | Estructura abierta de oficina | Diferencias al convertir |
| RTF | Texto con códigos de formato | Extractor incompleto |
| Página final o imagen | Orden de lectura/OCR |
DOCX y ODT: no basta con quitar etiquetas
Estos archivos son contenedores comprimidos con documentos XML y recursos. Un lector correcto debe reconstruir párrafos, tablas, notas y saltos en un orden razonable. El texto de encabezados, comentarios o cuadros puede estar en partes separadas. Dos importadores pueden contar distinto si uno incluye notas y otro solo el cuerpo.
ODT sigue un estándar abierto y DOCX una familia de formatos Office Open XML, pero “estándar” no significa que todas las aplicaciones presenten idéntica paginación. Fuentes ausentes, estilos y objetos importados alteran el resultado visual.
PDF: texto visible no siempre es texto extraíble
Un PDF puede guardar caracteres con coordenadas, sin la estructura lógica de párrafos. En documentos de varias columnas, la extracción puede mezclar líneas. Si el PDF procede de un escáner, cada página puede ser una fotografía: hace falta OCR, que introduce errores con tildes, guiones de final de línea y números.
Una prueba sencilla es intentar seleccionar una frase. Si no puedes, probablemente no existe una capa de texto. Si puedes pero al pegar cambia el orden, el problema es la estructura de lectura. No declares un recuento exacto sin revisar una muestra.
Caso práctico: presupuesto de traducción
Un cliente entrega un PDF de 28 páginas y pide precio por palabra. La extracción automática devuelve 7.840 palabras, pero tres páginas son escaneadas y dos tablas aparecen duplicadas por el orden de lectura. Tras OCR y revisión, el texto fuente útil es 8.215. La diferencia afecta el presupuesto. El profesional debe indicar formato recibido, herramienta de extracción, elementos excluidos y si el recuento es provisional.
TXT, Markdown y codificación
Un TXT suele ser el formato más predecible porque no contiene maquetación. Sin embargo, una codificación incorrecta puede convertir tildes o eñes en símbolos extraños. Markdown añade marcas como almohadillas, asteriscos y enlaces; decide si contarás el texto visible o también la sintaxis. Nuestro editor cuenta lo que se pega, no interpreta una vista renderizada.
Proceso recomendado
- Conserva el original y trabaja sobre una copia.
- Identifica si existe texto seleccionable.
- Extrae localmente cuando la confidencialidad lo requiera.
- Revisa una página con tablas, notas y varias columnas.
- Normaliza guiones de final de línea solo si realmente unen una palabra.
- Compara el recuento con la aplicación de origen.
- Documenta inclusiones, exclusiones y margen de error.
Qué no debería prometer una herramienta
Ningún importador puede garantizar que un PDF arbitrario conserve el orden semántico. Tampoco debería afirmar que un DOCX “nunca se sube” si el análisis ocurre en un servidor. La interfaz debe explicar formato compatible, lugar de procesamiento y elementos que se descartan.
Control de calidad por muestreo
Para documentos largos, compara al menos tres zonas: una página de prosa sencilla, otra con tablas o columnas y otra con notas o caracteres especiales. Cuenta manualmente una frase de cada zona y comprueba el texto extraído. Busca palabras pegadas, encabezados repetidos y guiones que sobreviven al salto de línea. Si el error se repite de forma sistemática, corrige el proceso antes de obtener el total.
El OCR merece una revisión adicional de nombres, cantidades y tildes. Una confusión entre “l” y “1” puede no alterar mucho el total de palabras, pero sí cambiar el contenido. Cuando el recuento acompaña una traducción o investigación, la fidelidad textual importa más que conseguir una cifra rápidamente.
Seguridad del archivo
No abras documentos inesperados con macros ni los subas a servicios desconocidos. Para contar basta una extracción de texto; no hace falta ejecutar contenido activo. En material confidencial, usa herramientas locales, elimina metadatos innecesarios de las copias y respeta la política de la organización.
Conclusión editorial
Para un borrador corriente, extraer texto y contar es suficiente. Para facturación, investigación o límites formales, el formato es parte del método: valida una muestra, conserva evidencia y acuerda qué contenido integra el total.
Fuentes y método
- Adobe Acrobat Help: reconocer texto en documentos escaneados — consultada 14 oct 2026.
- MDN: File API — consultada 14 oct 2026.
La interpretación y los ejemplos son responsabilidad del equipo editorial de CuentaCaracteres. Si detectas un error, consulta nuestra política de correcciones.